
Métodos de Compressão de Contexto no RAG: Como Reduzir até 70% dos Tokens com .MD, .TXT e Algoritmos
LER RESUMO
- Impacto do Formato de Arquivo: Converter documentos pesados (PDF, HTML, JSON) para Markdown (.md) ou Texto Puro (.txt) elimina marcações invisíveis, estilos redundantes e chaves repetitivas, reduzindo o consumo de tokens de entrada entre 40% e 80% antes mesmo da ingestão vetorial.
- Compressão Algorítmica com LLMLingua: O uso de modelos compactos de linguagem para calcular a perplexidade de tokens permite descartar preenchimentos e palavras redundantes do contexto recuperado, alcançando até 5x de compressão sem perda de raciocínio pelo modelo principal.
- Filtragem com Reranking Semântico: Combinar busca vetorial ampla com Cross-Encoders (Cohere Rerank ou BGE) reduz os chunks recuperados de 20 para 3 ou 5 ultra-relevantes, evitando o problema 'Lost in the Middle' e derrubando drasticamente os custos da API.
PRINCIPAIS TÓPICOS
- O Desafio do Contexto Longo: Por Que Comprimir Tokens?
- A Batalha dos Formatos: O Custo Real de PDF, HTML, JSON e XML
- Por Que Markdown (.md) e Texto Puro (.txt) São Imbatíveis
- Métodos Algorítmicos Avançados de Compressão
- Arquitetura de Pipeline RAG de Alta Eficiência
- Ferramentas Práticas e Automação de Conversão
- Boas Práticas e Armadilhas para Evitar
Quem constrói aplicações com Inteligência Artificial generativa e pipelines de RAG (Retrieval-Augmented Generation) logo descobre uma verdade incômoda: janelas de contexto enormes não são uma solução mágica, mas sim uma armadilha de custos e latência.
Quando um usuário faz uma pergunta, o sistema busca trechos de manuais, bases de conhecimento ou páginas web e injeta tudo isso no prompt do modelo (LLM). O problema é que, na maioria dos sistemas, esse contexto recuperado chega repleto de gordura digital: tags de código, metadados desnecessários, cabeçalhos repetidos e formatações pesadas.
O resultado? Contas astronômicas de tokens de entrada (input tokens), aumento considerável no tempo de resposta (Time to First Token - TTFT) e o temido fenômeno “Lost in the Middle” (quando o modelo se perde no excesso de texto e ignora a informação que realmente importava).
Neste artigo completo, vamos analisar os principais métodos de compressão de contexto recuperado, comparar a fundo o peso de cada formato de arquivo e mostrar como uma simples padronização para .md ou .txt pode cortar até 70% dos seus custos operacionais.
📉 O Desafio do Contexto Longo: Por Que Comprimir Tokens?
Mesmo com modelos modernos suportando 128k, 1 milhão ou até 2 milhões de tokens de contexto, injetar documentos brutos sem tratamento prévio traz 3 gargalos críticos:
- Custo Financeiro Multiplicativo: Cada consulta em produção reenvia todo o histórico e os trechos recuperados. Em modelos de fronteira, um fluxo com 10.000 tokens por requisição pode facilmente custar centenas de dólares por dia em escala moderada.
- Latência de Processamento: O cálculo de atenção (self-attention) na fase de prefill do LLM cresce com o tamanho do contexto. Menos tokens significam respostas instantâneas para o usuário.
- Degradação de Atenção (Needle in a Haystack): Pesquisadores de Stanford comprovaram que os modelos encontram informações com facilidade no início e no final do prompt, mas tendem a alucinar ou ignorar dados cruciais posicionados no meio de um contexto muito longo e poluído.
Comprimir o contexto recuperado não é apenas economizar centavos: é melhorar diretamente a precisão e a inteligência das respostas.
⚖️ A Batalha dos Formatos: O Custo Real de PDF, HTML, JSON e XML
A primeira linha de defesa contra o desperdício de tokens não exige algoritmos complexos: ela começa no pré-processamento dos dados brutos.
Muitos desenvolvedores cometem o erro de extrair o texto de um PDF com OCR bruto, raspar uma página HTML mantendo as tags ou enviar estruturas JSON gigantescas diretamente ao modelo. Veja como cada formato se comporta:
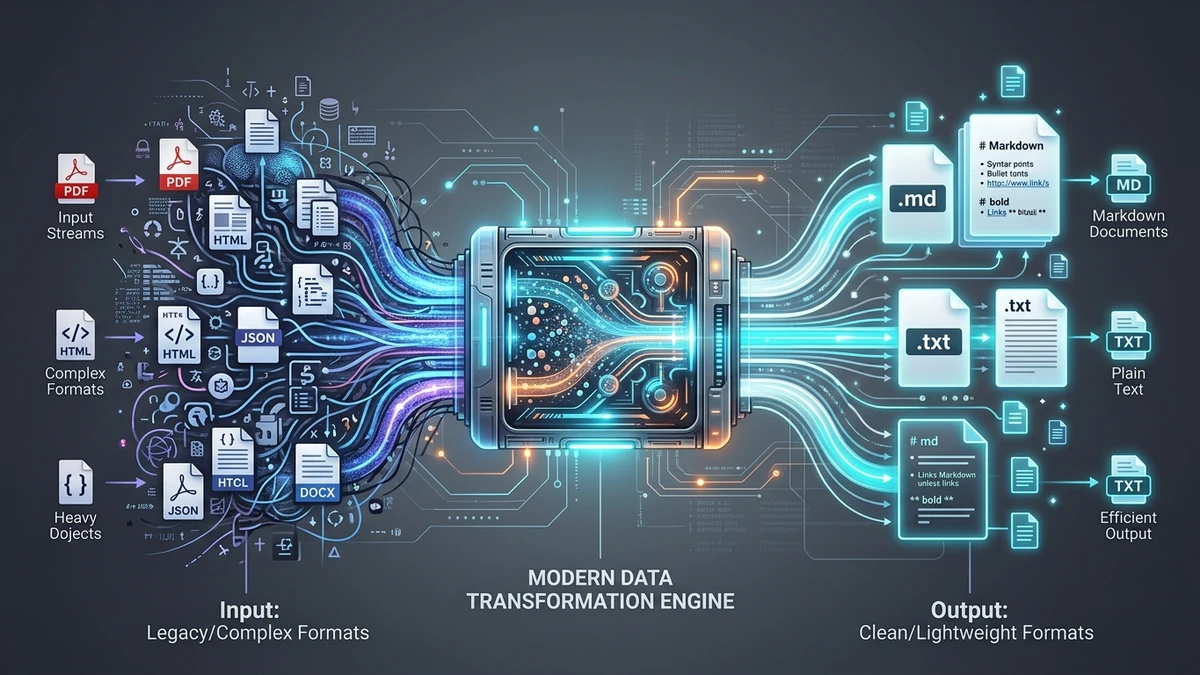
1. PDF (.pdf) — O Campeão do Desperdício Oculto
O PDF foi projetado para impressão gráfica, não para leitura semântica. Ao extrair texto cru de um PDF corporativo:
- Cabeçalhos e rodapés com paginação (“Página 42 de 120”, “Confidencial”) repetem-se centenas de vezes.
- Quebras de linha e hifenizações artificiais quebram palavras ao meio.
- Tabelas viram sequências caóticas de coordenadas e caracteres soltos.
- Overhead típico de tokens: 40% a 70% de ruído inútil.
2. HTML (.html, .htm) — O Poluidor das Páginas Web
Quando você faz web scraping de um artigo ou documentação:
- Classes de estilização (
class="flex items-center px-4 py-2 text-sm text-gray-500"), tags vazias (<div></div>), scripts JS e SVGs inflacionam o texto. - O modelo gasta tokens preciosos tentando entender aninhamentos de tags que nada acrescentam à resposta.
- Overhead típico de tokens: 60% a 85% de código puramente visual.
3. JSON (.json) — Excelente para Máquinas, Caro para LLMs
O JSON é a linguagem universal de APIs, mas para passar contexto textual a um LLM ele é extremamente verboso:
- As chaves de propriedades se repetem a cada objeto:
{"cliente_id": 101, "nome": "Ana", "status": "ativo"}. - Aspas duplas, dois pontos, chaves e colchetes consomem de 1 a 2 tokens por pontuação.
- Overhead em listas tabulares: consome de 2x a 3x mais tokens do que o mesmo dado formatado em tabela Markdown ou CSV.
4. XML (.xml) — Dupla Penalidade de Fechamento
Se o JSON já é verboso, o XML é pior. A necessidade obrigatória de tags de fechamento (<historico_medico>...</historico_medico>) e atributos de namespace faz com que o mesmo dado ocupe um volume ainda maior de tokens.
5. DOCX (.docx) e RTF — O Labirinto do Office
Arquivos do Word são, na verdade, pacotes compactados de dezenas de esquemas XML internos. Extrações ingênuas arrastam metadados de fontes, estilos de parágrafo e marcas de revisão que em nada ajudam o raciocínio da IA.
6. CSV e TSV (.csv, .tsv) — Ultra-Compactos, mas Frágeis
Para dados puramente tabulares, o CSV é imbatível em economia de caracteres. No entanto, se o trecho for fatiado (chunking) no meio da tabela e perder o cabeçalho original, o LLM perde a semântica das colunas.
7. YAML (.yaml, .yml) — A Alternativa Inteligente ao JSON
Para metadados estruturados que precisam acompanhar o texto (como autor, data e categoria), o YAML elimina aspas e chaves obrigatórias, gerando uma economia imediata de 20% a 30% em relação ao JSON correspondente.
Tabela Comparativa de Formatos para RAG
| Formato de Origem | Nível de Ruído / Desperdício | Densidade de Informação | Recomendação para RAG |
|---|---|---|---|
| PDF (.pdf) | 🔴 Muito Alto (50% a 70%) | Baixa (devido a layout quebrado) | Obrigatório converter antes de indexar |
| HTML (.html) | 🔴 Extremo (60% a 85%) | Baixa (poluído com DOM/CSS) | Sanitizar para Markdown ou texto limpo |
| XML (.xml) | 🔴 Alto (40% a 60%) | Média | Reestruturar em YAML ou Markdown |
| JSON (.json) | 🟡 Moderado (30% a 50%) | Média (chaves repetidas) | Usar apenas para schemas de ferramentas |
| DOCX (.docx) | 🟡 Moderado (30% a 40%) | Média | Converter para Markdown com Pandoc |
| YAML (.yaml) | 🟢 Baixo (10% a 20%) | Alta | Ideal para metadados de cabeçalho |
| CSV / TSV | 🟢 Muito Baixo (< 10%) | Altíssima (dados tabulares) | Ótimo para tabelas puras com header fixo |
| Markdown (.md) | 🟢 Mínimo (5% a 10%) | Máxima estruturada | Padrão Ouro oficial da indústria |
| Texto Puro (.txt) | 🟢 Zero (0% de overhead) | Máxima não-estruturada | Perfeito para transcrições e narrativas |
🏆 Por Que Markdown (.md) e Texto Puro (.txt) São Imbatíveis
Se você busca a maior eficiência possível sem perder precisão, transformar sua base de conhecimento para Markdown (.md) e Texto Puro (.txt) é o investimento de maior retorno que você pode fazer.
A Supremacia do Markdown (.md)
- Treinamento Nativo dos Modelos: Praticamente todos os grandes modelos de linguagem (GPT-4o, Claude 3.5 Sonnet, Gemini 1.5/2.0, DeepSeek V3/R1) foram treinados com terabytes de documentação em Markdown no GitHub, Stack Overflow e Wikipedia. Eles entendem a sintaxe nativamente com mínimo esforço cognitivo.
- Hierarquia Semântica com Custo Mínimo: Um simples
#define um título principal; um-define um item de lista; barras verticais|delimitam colunas. Isso preserva o contexto semântico gastando apenas 1 ou 2 tokens, enquanto em HTML isso exigiria dezenas de caracteres. - Fatiamento (Chunking) Preciso: Ferramentas de particionamento semântico conseguem quebrar documentos Markdown respeitando seções (
##), garantindo que nenhum bloco de texto perca seu tópico de origem.
Quando Usar Texto Puro (.txt)
O .txt é a escolha ideal quando o documento não possui hierarquia ou tabelas essenciais. Transcrições de reuniões, depoimentos de clientes, logs de atendimento e artigos puramente narrativos atingem a taxa de compressão máxima em .txt, garantindo 100% de aproveitamento de cada token pago.
🧠 Métodos Algorítmicos Avançados de Compressão
Além da higienização dos formatos de arquivo, a engenharia de IA moderna desenvolveu técnicas algorítmicas de compressão de contexto recuperado. Elas atuam entre a busca no banco vetorial e o envio final para o LLM.
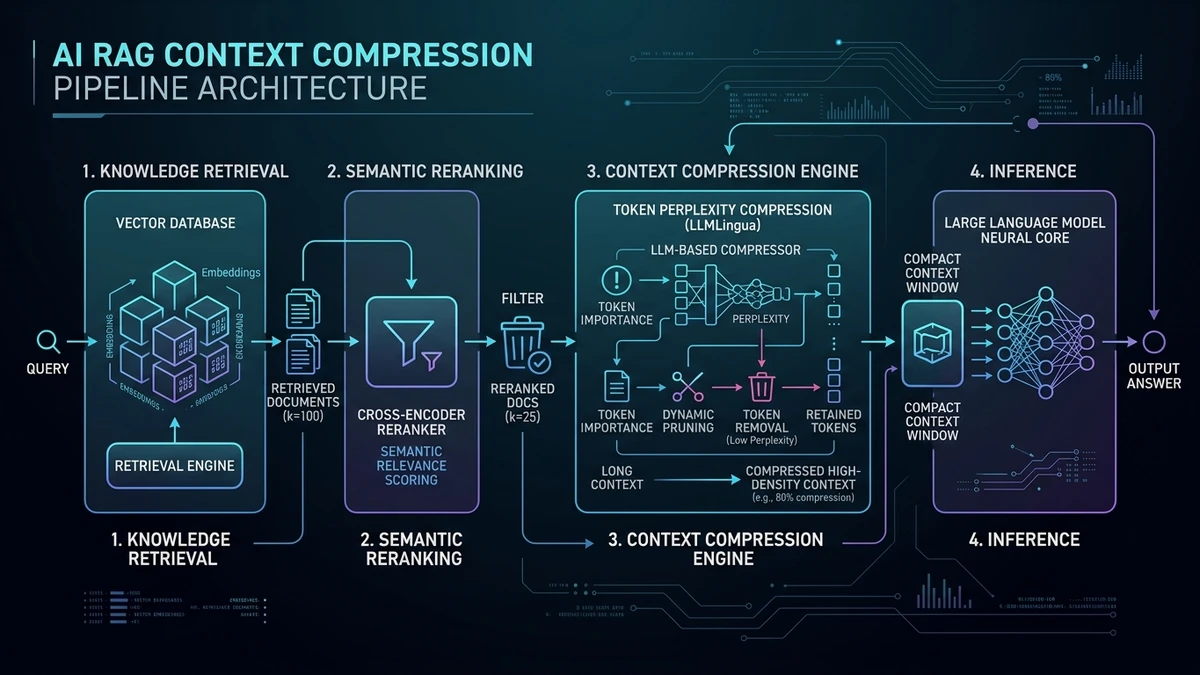
1. Compressão Seletiva por Perplexidade (LLMLingua e LongLLMLingua)
Criado por pesquisadores da Microsoft, o LLMLingua é uma das inovações mais poderosas em economia de tokens.
- Como funciona: Um modelo de linguagem pequeno e ultra-rápido (SLM, como LLaMA-2-7B ou GPT-2 pequeno) avalia cada token do contexto recuperado e calcula sua perplexidade em relação à pergunta do usuário.
- O que ele faz: Tokens de baixa informação (artigos repetidos, introduções vazias, frases de transição) são descartados.
- O resultado: Reduz o tamanho do prompt em 2x a 5x (até 80% de corte de tokens), mantendo a capacidade do modelo principal de responder à pergunta com a mesma precisão.
2. Reranking Semântico com Cross-Encoders
A busca vetorial tradicional por similaridade de cosseno (embeddings) costuma retornar muitos trechos com falsos positivos.
- Se o seu sistema recupera os Top-20 chunks, passar todos ao LLM custará facilmente 8.000 tokens.
- Ao aplicar um Reranker (como Cohere Rerank ou BAAI/bge-reranker), o modelo reclassifica os trechos por relevância profunda com a pergunta.
- Você pode então descartar os 15 trechos inferiores e enviar apenas os Top-3 a Top-5 melhores, cortando instantaneamente 75% dos tokens sem perder nada de valor.
3. Contextual Chunking e Deduplicação Inteligente
Muitos manuais e sites possuem parágrafos inteiros duplicados (avisos legais, termos de serviço, resumos repetidos).
- Implementar algoritmos de deduplicação de texto (como MinHash ou hash semântico) antes da montagem do prompt evita que o modelo receba 3 cópias do mesmo parágrafo.
- O Contextual Chunking adiciona uma linha de resumo gerada previamente a cada bloco, permitindo que os blocos sejam muito menores e mais focados.
4. Camada de Sumarização com Modelos Ultrarrápidos (Map-Reduce)
Se você precisa analisar um relatório de 100 páginas:
- Em vez de enviar o relatório inteiro para um modelo de raciocínio caro, use um modelo ultra-econômico e veloz (como Gemini 1.5 Flash ou Claude 3.5 Haiku) para extrair apenas os pontos-chave e métricas relativas à pergunta.
- O modelo principal recebe apenas o resumo condensado de 500 tokens, e não o texto original de 40.000 tokens.
🏗️ Arquitetura de Pipeline RAG de Alta Eficiência
Integrando todos esses conceitos, a arquitetura de um pipeline RAG otimizado para custo e precisão segue 4 etapas claras:
[Documentos Brutos: PDF, HTML, JSON, DOCX]
                  │
                  ▼ (Etapa 1: Pré-processamento e Limpeza)
      [Conversão para Markdown / .TXT]
                  │
                  ▼ (Etapa 2: Ingestão e Indexação Vetorial)
        [Banco Vetorial / Embeddings]
                  │
             (Query do Usuário)
                  │
                  ▼ (Etapa 3: Recuperação Ampla: Top-25 Chunks)
        [Cross-Encoder / Reranker Semântico]
                  │
                  ▼ (Etapa 4: Filtragem: Top-5 Chunks Mais Relevantes)
         [LLMLingua: Compressão de Perplexidade]
                  │
                  ▼ (Contexto Hiper-Compactado: -70% de Tokens)
              [LLM Principal (GPT-4o / Claude / DeepSeek)]
                  │
                  ▼
              [Resposta Precisa, Rápida e Barata]
🛠️ Ferramentas Práticas e Automação de Conversão
Para colocar essa transformação em prática no seu sistema ou automação, existem excelentes bibliotecas de código aberto:
1. Microsoft MarkItDown
O MarkItDown é uma ferramenta oficial da Microsoft para converter arquivos em Markdown estruturado com suporte a:
- PDF, Word (.docx), PowerPoint (.pptx), Excel (.xlsx)
- Imagens com OCR, áudio com transcrição e páginas HTML
- Comando rápido em Python:
pip install markitdownfrom markitdown import MarkItDown md = MarkItDown() result = md.convert("manual_completo.pdf") with open("manual_limpo.md", "w", encoding="utf-8") as f: f.write(result.text_content)
2. Trafilatura (Para Web Scraping Limpo)
Se você ingere páginas da web, esqueça o HTML bruto. O Trafilatura remove automaticamente menus, rodapés, anúncios e banners de cookies, retornando apenas o texto editorial em Markdown ou texto limpo:
import trafilatura

downloaded = trafilatura.fetch_url('https://exemplo.com/artigo')
texto_markdown = trafilatura.extract(downloaded, output_format='markdown')
3. LLMLingua no Python
Para integrar compressão em tempo de execução:
from llmlingua import PromptCompressor

compressor = PromptCompressor()
contexto_bruto = "... seus 10 chunks recuperados do banco vetorial ..."

compressed_prompt = compressor.compress_prompt(
    contexto_bruto,
    instruction="Responda com base no contexto:",
    question="Qual foi o faturamento da empresa no terceiro trimestre?",
    target_token=1000  # Limite máximo de tokens desejado
)

print(f"Tokens originais: {compressed_prompt['origin_tokens']}")
print(f"Tokens compactados: {compressed_prompt['compressed_tokens']}")
⚠️ Boas Práticas e Armadilhas para Evitar
Ao aplicar métodos de compressão de contexto, fique atento a estes pontos de atenção:
- Cuidado com Dados Numéricos e Cláusulas Críticas: A compressão algorítmica agressiva (como taxas de compressão acima de 4x no LLMLingua) pode ocasionalmente descartar pequenas preposições ou números em contratos jurídicos e laudos médicos. Em domínios de alto risco, prefira a combinação de Reranking + Conversão em Markdown em vez de podar tokens internamente.
- Mantenha os Cabeçalhos de Tabelas: Ao converter planilhas ou bancos para Markdown ou CSV, certifique-se de que cada pedaço fatiado mantenha o cabeçalho original das colunas. Uma tabela com números sem nome de coluna faz a IA inventar interpretações.
- Monitore a Taxa de Fidelidade: Meça periodicamente o impacto da compressão na assertividade das respostas usando frameworks de avaliação de RAG (como Ragas ou TruLens). Na grande maioria dos casos práticos, uma redução de 50% a 70% nos tokens não gera perda perceptível de qualidade e melhora a velocidade do sistema.
🎯 Conclusão: Comece Simples e Escale
Reduzir custos e acelerar sistemas de IA não exige necessariamente trocar de modelo ou esperar que as empresas de tecnologia baixem o preço das APIs. A maior alavanca de otimização está naquilo que você entrega para o modelo ler.
Comece padronizando sua base de dados para Markdown (.md) e eliminando o lixo estrutural de PDFs e páginas HTML. Em seguida, adicione uma etapa de Reranking na recuperação do seu banco vetorial. Se o seu volume de consultas for elevado, finalize incorporando o LLMLingua para aparar os excessos.
Com essas práticas, seu sistema de IA responderá com maior agilidade, eliminará alucinações causadas pelo excesso de contexto e economizará milhares de reais em tokens todos os meses.